Terraform で AWS 上に簡易的な RAG(検索拡張生成)を作り、設定を変えながら実験しました。架空の会社の社内資料 6 本と質問 20 問で試したところ、RAG なしの正解率は 15%、RAG ありは 90%、設定を工夫すると 100% になりました。
サーバーは「起動から 1 時間で自分を削除する」作りにして、費用は全部で 20 円前後(使用量からの概算)に収まりました。構築と実験は Claude Code に任せ、私は方針の決定と結果の確認をしました。認識が間違っているところがあれば、ぜひ教えてください。
この記事では、次の 4 つを振り返ります。
- どんな構成で、資料と質問がどう流れるのか(構成図つき)
- 埋め込みと生成、2 つの AI がそれぞれ何をしているのか
- 1 時間で自分を削除する 2 重のタイマーと、その実測
- 実験の結果(RAG あり・なし、チャンクの大きさ、取り出す件数)
1. 作ったもの
| 項目 | 内容 |
|---|---|
| 構築 | Terraform(VPC から削除タイマーまで 26 リソース) |
| サーバー | EC2 t3.small(Amazon Linux 2023、Python 3.12) |
| 埋め込み AI | Amazon Titan Text Embeddings v2(1024 次元) |
| 生成 AI | Amazon Nova 2 Lite(Bedrock の jp. 推論プロファイル経由) |
| ベクトル検索 | numpy の内積だけ(ベクトル DB は使わない) |
| 操作 | 手元の PC から SSM Run Command(SSH を使わずにサーバーへコマンドを送る仕組み) |
| 資料 | 架空の会社「ミカン電機」の社内資料 6 本(666〜903 字) |
| 評価 | 答えのある質問 20 問+答えのない質問 4 問 |
Bedrock は、AWS の生成 AI を API で呼び出せるサービスです。推論プロファイルは、呼び出し先のリージョンを自動で振り分ける窓口で、jp. は東京と大阪に振り分けます。
方針は「とにかく簡易に、消し忘れない」です。資料が 6 本しかないので、OpenSearch や Knowledge Bases のような最低料金のかかる仕組みは使わず、numpy の内積で探すだけにしました。
2. RAG の全体像
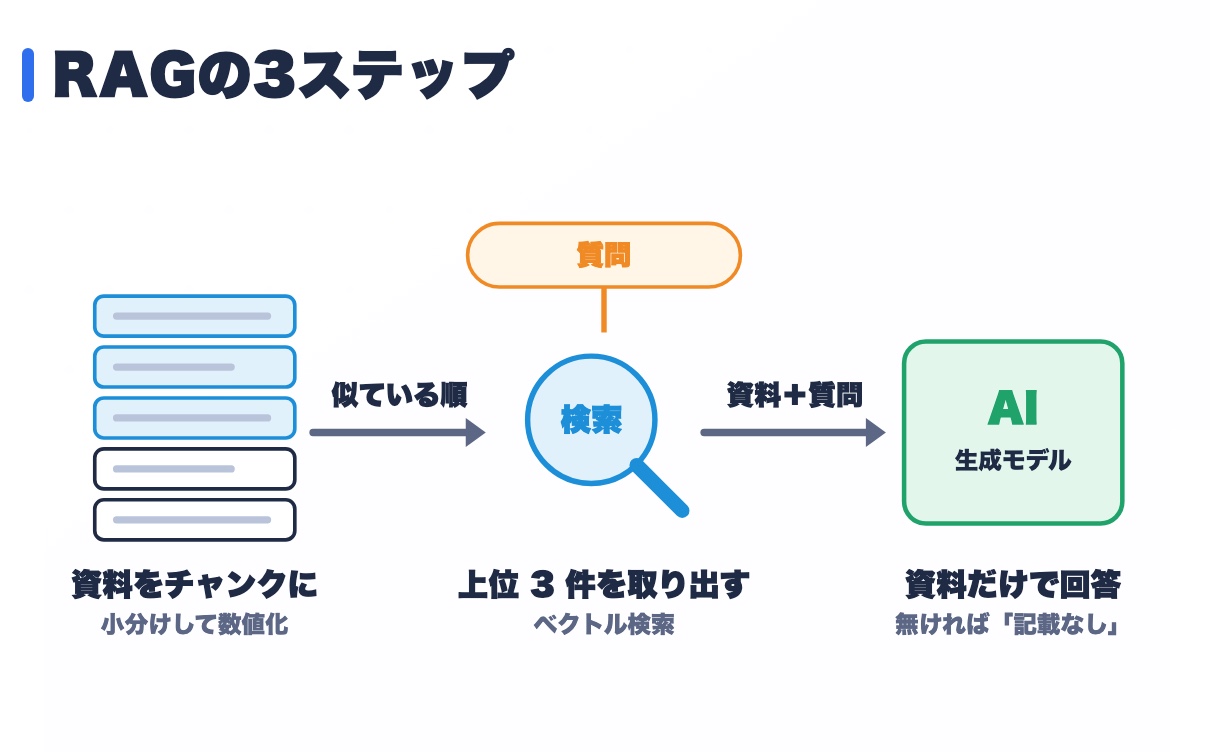
RAG は 3 段階です。
- 資料を短いかたまり(チャンク)に分け、それぞれを数字の列(ベクトル)にしておく
- 質問も同じように数字にして、近いチャンクを上位 k 件取り出す
- 取り出したチャンクと質問を生成 AI に渡し、資料だけを根拠に答えさせる
ここで AI が 2 種類出てきます。ここがあいまいだと全体が分かりにくくなるので、次の 2 章で分けて説明します。
3. 埋め込み:文章を 1024 個の数字にする
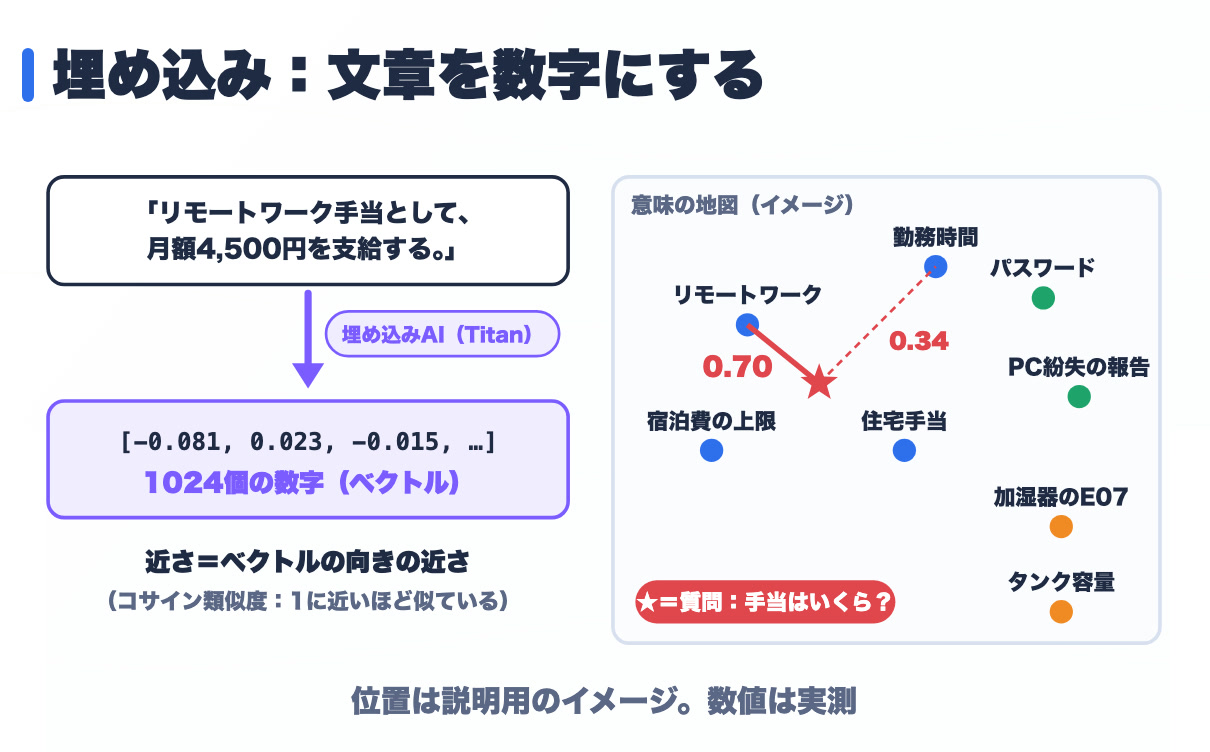
埋め込み AI(Titan)に文章を渡すと、1024 個の数字が返ってきます。例えば「リモートワーク手当として、月額 4,500 円を給与と合わせて支給する。」は、[-0.081, 0.023, -0.015, …] のようなベクトルになります。
意味が近い文章ほど、ベクトルの向きが近くなります。 近さはコサイン類似度(1 に近いほど似ている)で測ります。normalize: true で長さを 1 にそろえているので、内積を取るだけでコサイン類似度になります。
qv, _ = embed(query, self.dims)          # 質問もベクトルに
scores = self.matrix @ qv                 # 全チャンクとの内積 = コサイン類似度
top = np.argsort(-scores)[:k]             # 近い順に k 件
150 字のチャンクで単発に測ると、「リモートワーク手当はいくらですか?」に対して、リモートワークの章が類似度 0.70 で 1 位、2 位は勤務時間の章で 0.34 でした。
ただし万能ではありません。「在宅勤務の手当はいくら?」と言い換えると、リモートワークの章は上位 3 件に入りませんでした(1 位でも類似度 0.27)。意味で探せるといっても、資料と同じ言葉で聞くほど当たりやすい、というのが実感です。
4. 生成:資料を読んで答える
検索で見つかるのは資料の切れ端だけです。それを答えの文章にするのが生成 AI(Nova 2 Lite)の役割です。渡すのは指示(system)と、資料と質問をまとめた 1 通のメッセージです。中身は次の 3 つに分かれます。
| 部分 | 中身 | 例 |
|---|---|---|
| 指示(system) | 資料だけを根拠に答える。無ければ「資料に記載がありません」と答える | 下のコードのとおり |
資料(<context>) |
検索で 1〜3 位だったチャンク | 経費精算規程の宿泊費を含むチャンクなど |
| 質問 | 利用者の質問そのもの | 大阪市内のホテル代の上限は? |
SYSTEM_PROMPT = (
    "あなたは社内資料に基づいて回答するアシスタントです。"
    "必ず <context> 内の情報だけを根拠に、日本語で簡潔に回答してください。"
    "根拠が <context> に無い場合は推測せず「資料に記載がありません」とだけ答えてください。"
)
1 問あたりの入力は平均約 760 トークン(標準設定)でした。トークンは AI が文章を数える単位で、料金の基準になります。単発で測ると、埋め込みが約 0.1 秒、検索が 0.1 ミリ秒未満、生成が約 0.7 秒で、1 問 1 秒ほどで返ってきます。
| AI | 役割 | 入力 → 出力 |
|---|---|---|
| 埋め込み(Titan) | 探す係 | 文章 → 1024 個の数字 |
| 生成(Nova 2 Lite) | 答える係 | 指示+資料 3 件+質問 → 回答文 |
5. AWS の構成とデータの流れ
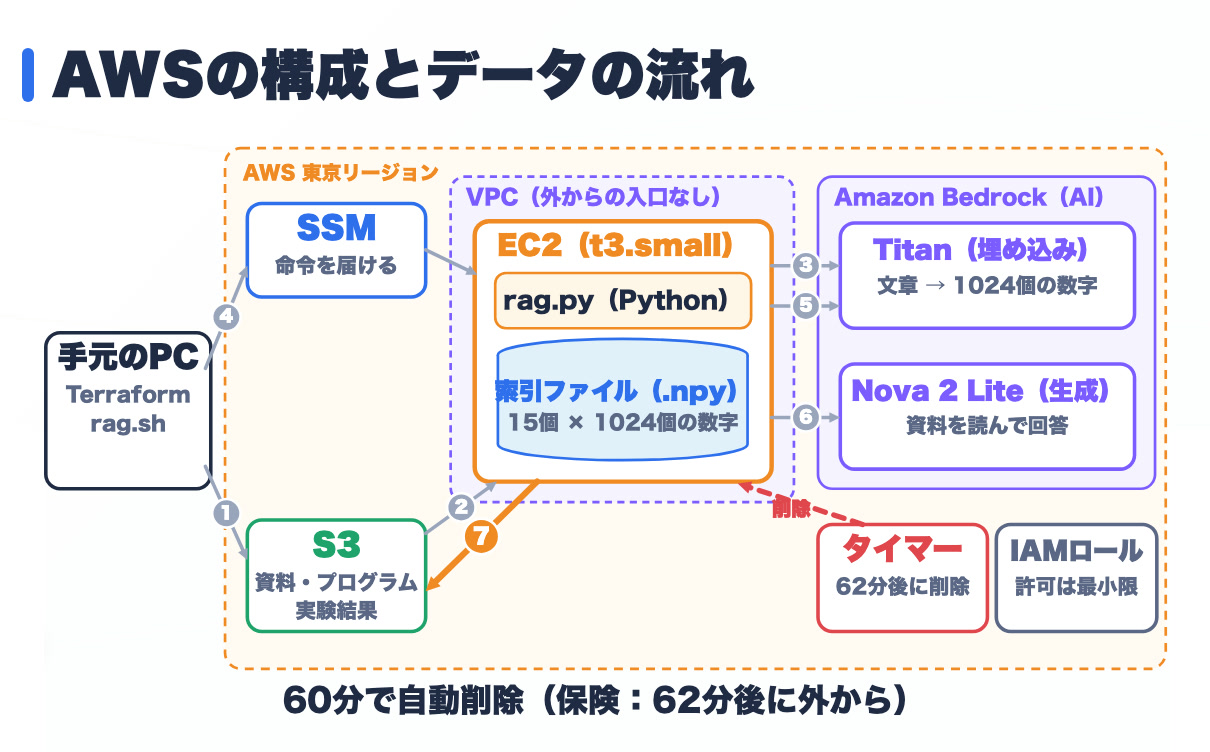
番号の順に、資料と質問がどう流れるかを追います。
terraform applyで、資料 6 本とプログラムを S3 に置く- EC2 が起動すると、user_data(初回起動時に自動で実行されるスクリプト)で S3 から資料とプログラムを取ってくる
- EC2 上で資料を 15 個のチャンク(400 字・50 字重ね)に分け、1 つずつ Titan で数字にする。結果は EC2 のディスクに 1 つの
.npyファイル(約 60KB) として保存する。これがベクトル DB の代わり - 質問は、手元の PC から SSM を通って EC2 に届く
- EC2 は質問も Titan で数字にして、
.npyと比べて近い 3 件を選ぶ - 選んだ 3 件と質問を Nova 2 Lite に渡して、答えを作ってもらう
- 実験結果(JSON と Markdown)を S3 に保存する(手元の PC へは、あとで S3 からダウンロードする)
つまり、資料の原本は S3、数字にした索引は EC2 のディスク、AI は Bedrock という分担です。
実際に作られた VPC の中身は、AWS CLI の describe 結果から draw.io で図にしました(凡例の「管理アクセス(SSH / RDP)」は図の共通の凡例で、今回は使っていません)。
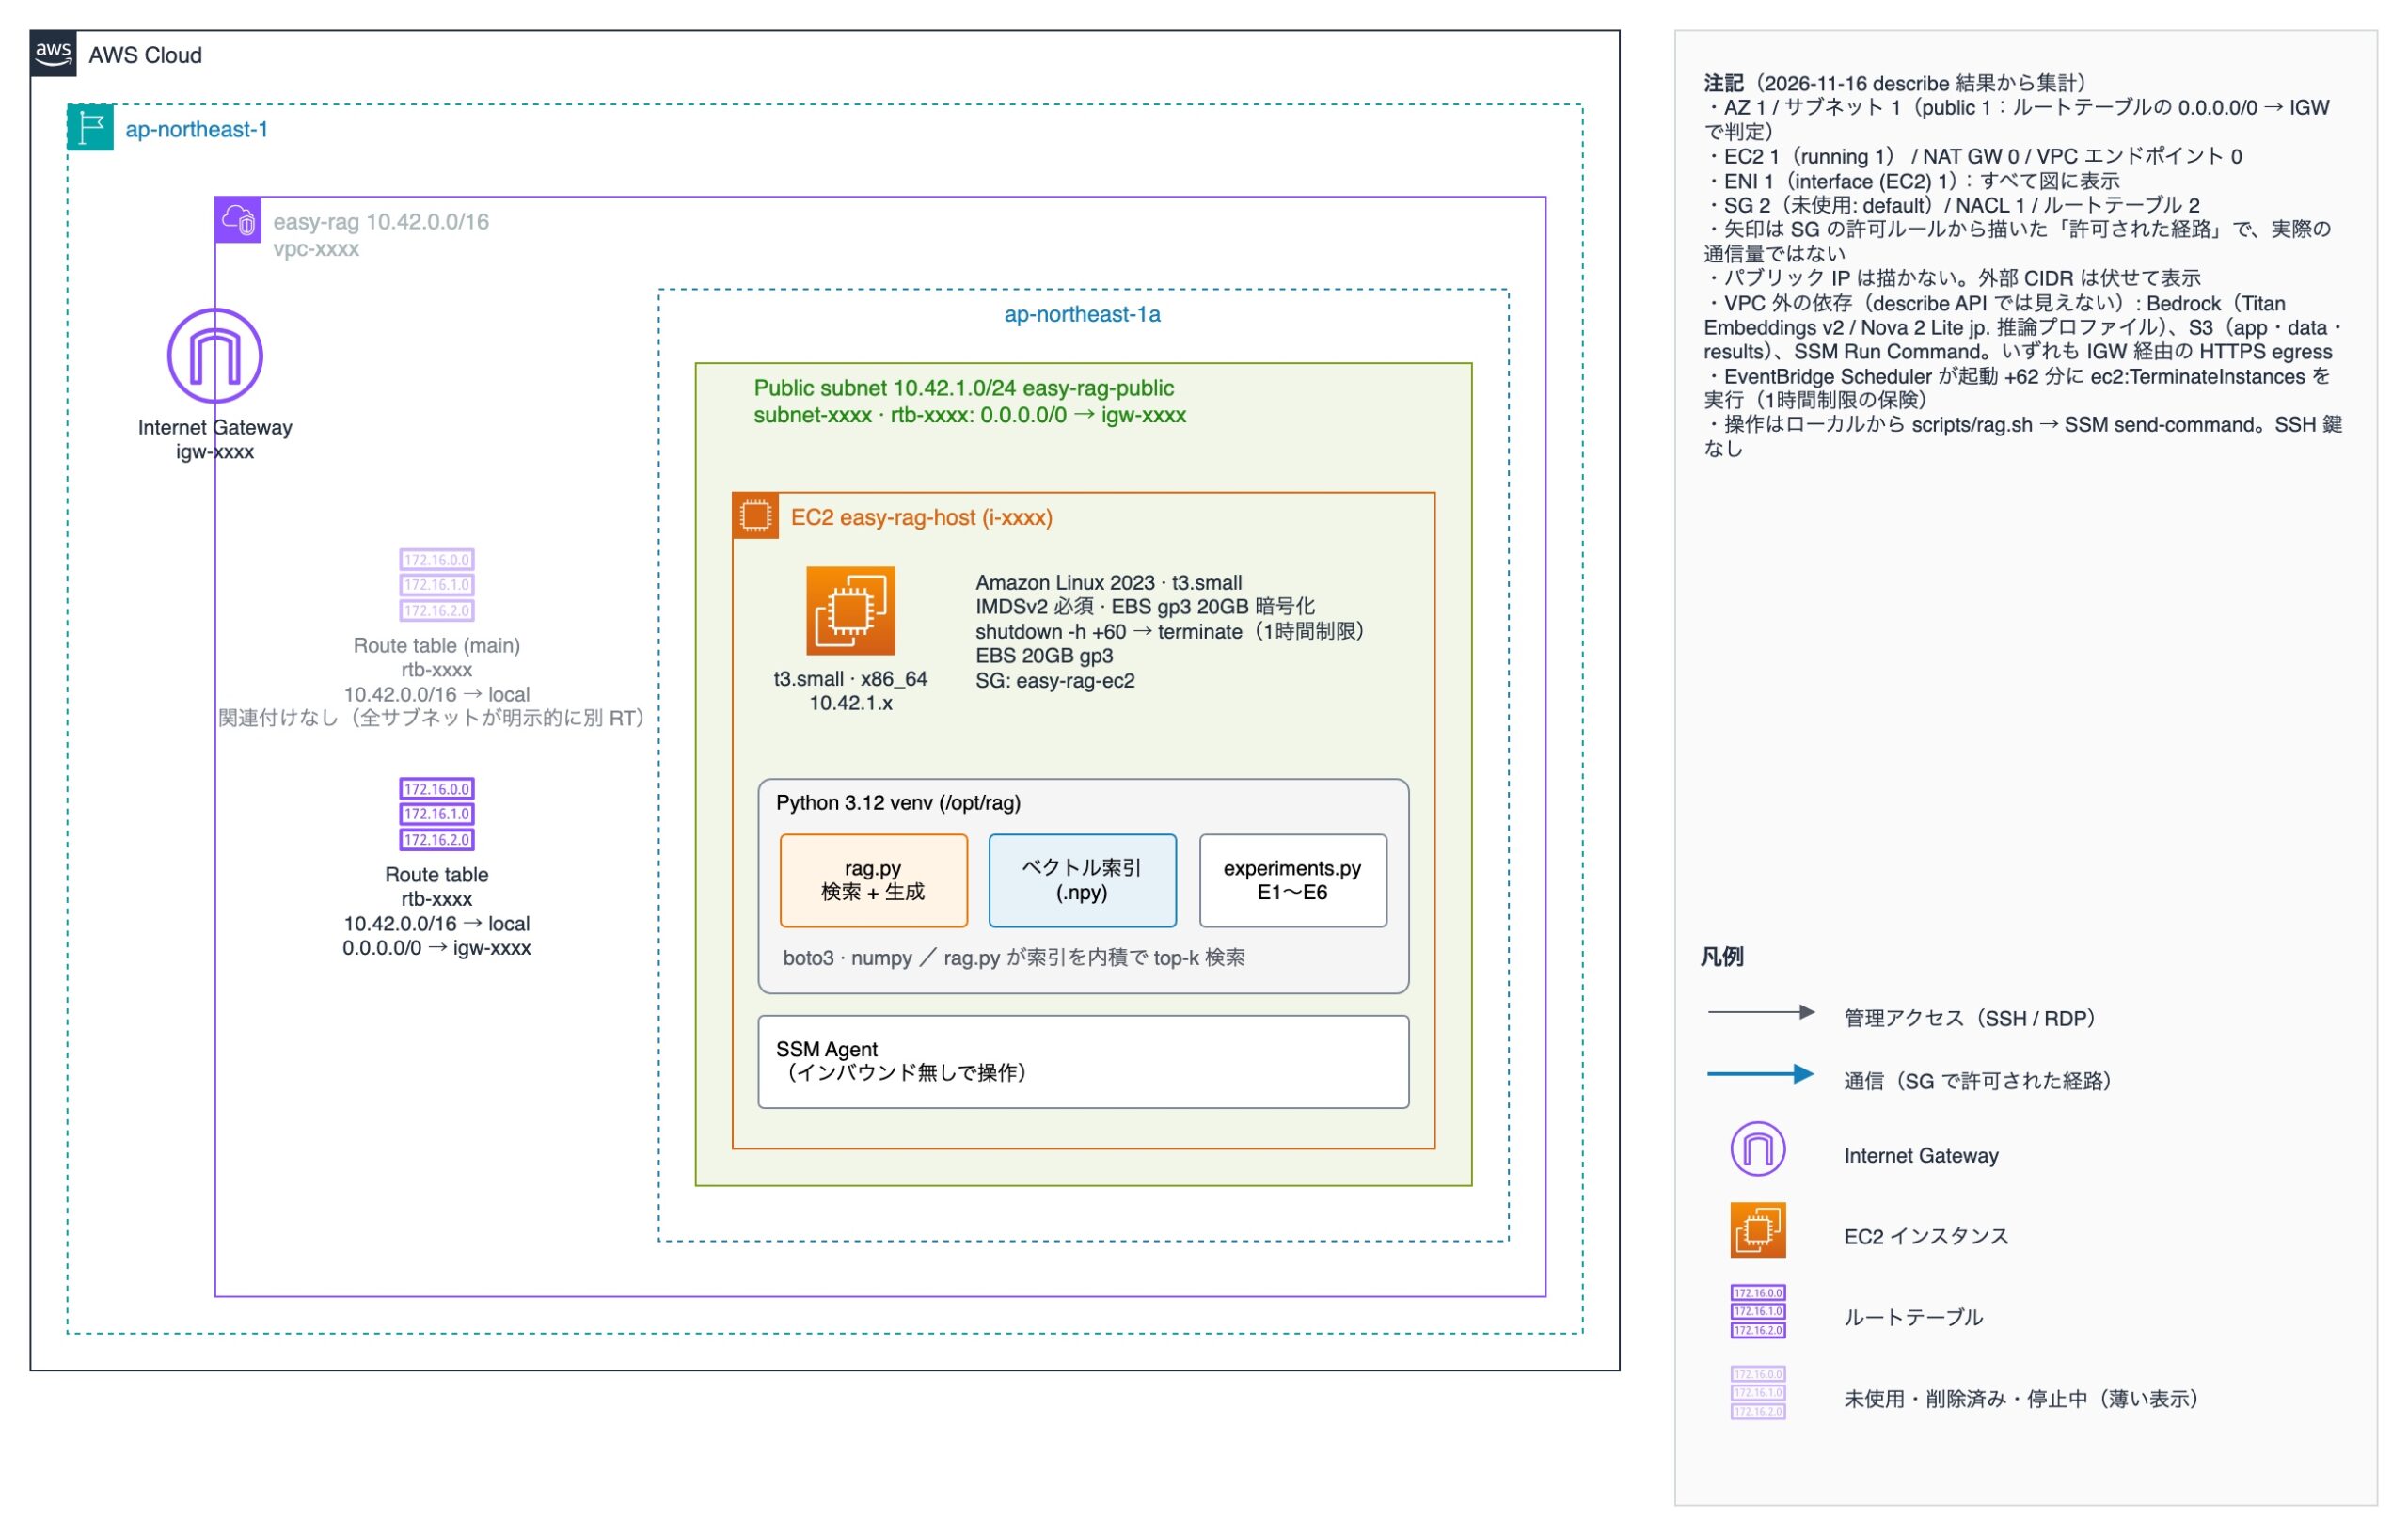
- パブリックサブネット 1 つ、NAT Gateway(プライベートサブネットから外へ出るための有料の出口)なし(費用を抑えるため)
- セキュリティグループ(EC2 の通信を許可するファイアウォール)はインバウンドを全部閉じた。操作は SSM だけで、SSH の鍵も作らない
- EC2 の IAM ロール(EC2 に渡す AWS 操作の権限)に許すのは、Bedrock の呼び出しと、自分のバケットの読み書きと、SSM だけ
6. 1 時間で自分を消す仕組み
実験用のサーバーは消し忘れが怖いので、2 重のタイマーを付けました。
# user_data の冒頭:起動直後に 60 分後のシャットダウンを予約
shutdown -h +60 "easy-rag: max lifetime 60min reached"
resource "aws_instance" "rag" {
# シャットダウン=停止ではなく削除
instance_initiated_shutdown_behavior = "terminate"
# ...
}
# 保険:OS が固まっても、62 分後に外から削除する
resource "aws_scheduler_schedule" "terminate" {
schedule_expression = "at(${formatdate("YYYY-MM-DD'T'hh:mm:ss",
timeadd(time_static.launched.rfc3339, "62m"))})"
target {
arn = "arn:aws:scheduler:::aws-sdk:ec2:terminateInstances"
input = jsonencode({ InstanceIds = [aws_instance.rag.id] })
# ...
}
}(コードは抜粋・簡略化しています。実際は 62m を max_lifetime_minutes + 2 分で計算しています)
max_lifetime_minutes 変数には 5〜60 の validation を付けたので、60 分を超える値は terraform plan の時点で弾かれます。
10 秒ごとに describe-instances を見て記録したところ、起動から 60.7 分で terminated になりました。1 段目の OS のシャットダウンで消えたので、2 段目の Scheduler が実際に動くところは見ていません。
| 時刻(UTC) | 状態 | 起動からの経過 |
|---|---|---|
| 11:48:55 | 起動 | 0 分 |
| 12:49:27 | shutting-down | 約 60.5 分 |
| 12:49:38 | terminated | 約 60.7 分 |
7. 実験① RAG の効果
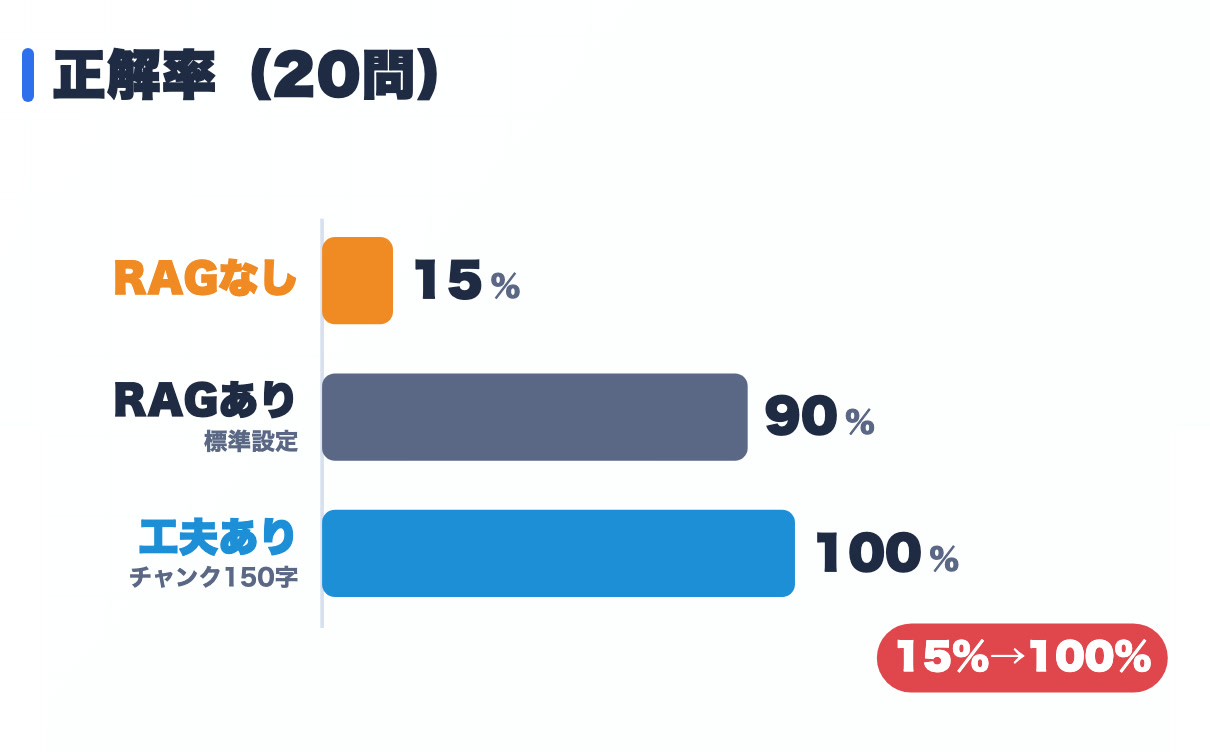
正解の判定は、回答に期待するキーワード(例:「4500」)が含まれているかで自動で行いました。カンマや空白は取り除いてから比べています。
| 条件 | 正解率 | 入力トークン(平均) |
|---|---|---|
| RAG なし(資料を渡さない) | 15% | 71 |
| RAG あり(400 字・3 件) | 90% | 764 |
| RAG あり(150 字・3 件) | 100% | 419 |
RAG なしで正解した 3 問は、「一般的にありがちな答え」がたまたま一致しただけでした。
怖かったのは、資料に無いことを聞いたときです。 「MK-Humi 3(架空の加湿器)の騒音は何 dB?」と聞くと、RAG なしの AI は「約 55dB(A) 以下」と、存在しない数値を作って答えました。RAG ありは、答えのない質問 4 問すべてで、資料に無いと断りました(目視で確認。自動判定は「記載はありません」のような表記ゆれを拾えず 3/4)。
8. 実験② チャンクの大きさと取り出す件数
8.1 チャンクの大きさ
| チャンク(重ね幅) | 正解率 | 入力トークン(平均) | チャンク数 |
|---|---|---|---|
| 150 字(30 字) | 100% | 419 | 40 |
| 400 字(50 字) | 90% | 764 | 15 |
| 1000 字(100 字) | 100% | 1,565 | 6 |
真ん中の 400 字だけ負けました。外した 2 問のうち 1 問が「グリーン車を使えるのはどんな場合?」(Q20)です。
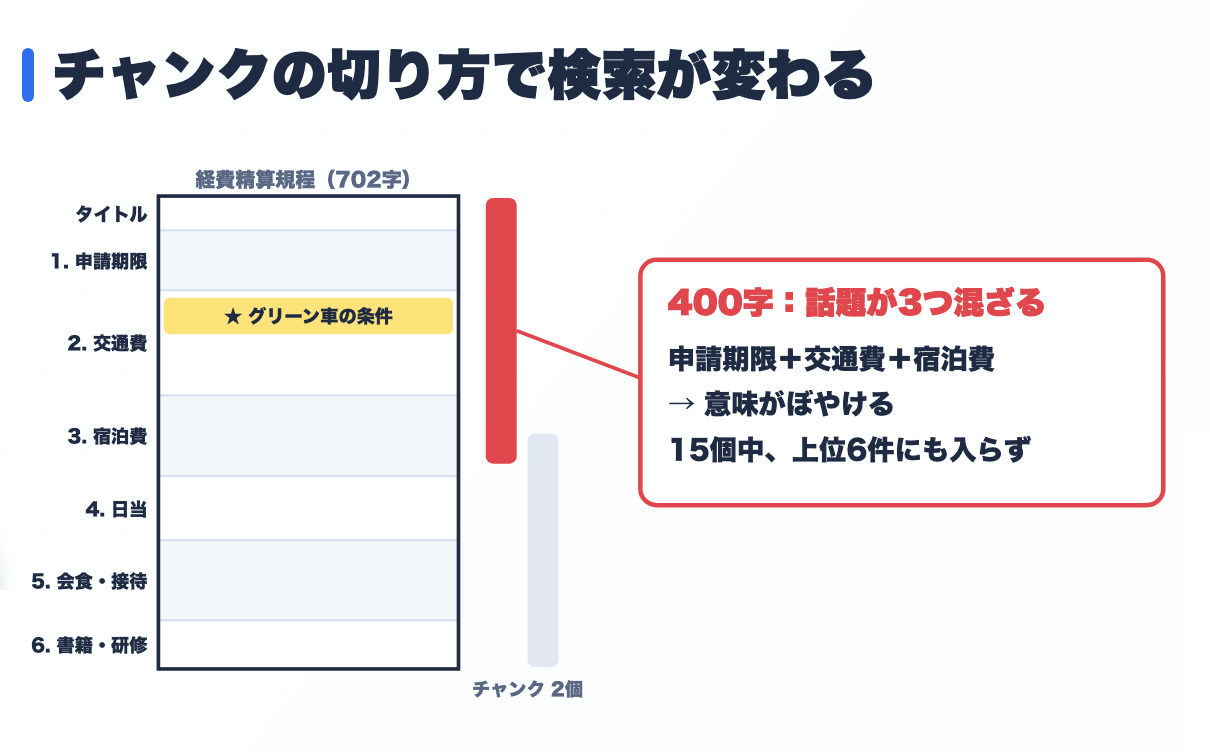
400 字のチャンクには、答えの文(交通費の章)と一緒に、申請期限・宿泊費の話も入っていました。答えを含むチャンクは類似度 0.12 以下で、15 個中の上位 6 件にも入りませんでした。話題が混ざって意味がぼやけたためと考えています(推定)。
もう 1 問(Q07「PC を紛失したら…」)は、検索では根拠を 1 位で取れていました。しかし AI が「PC を紛失した場合」と資料の「紛失・盗難を発見した場合」を同じものと見なせず、「資料に記載がありません」と断りました。こちらは生成側の失敗です。
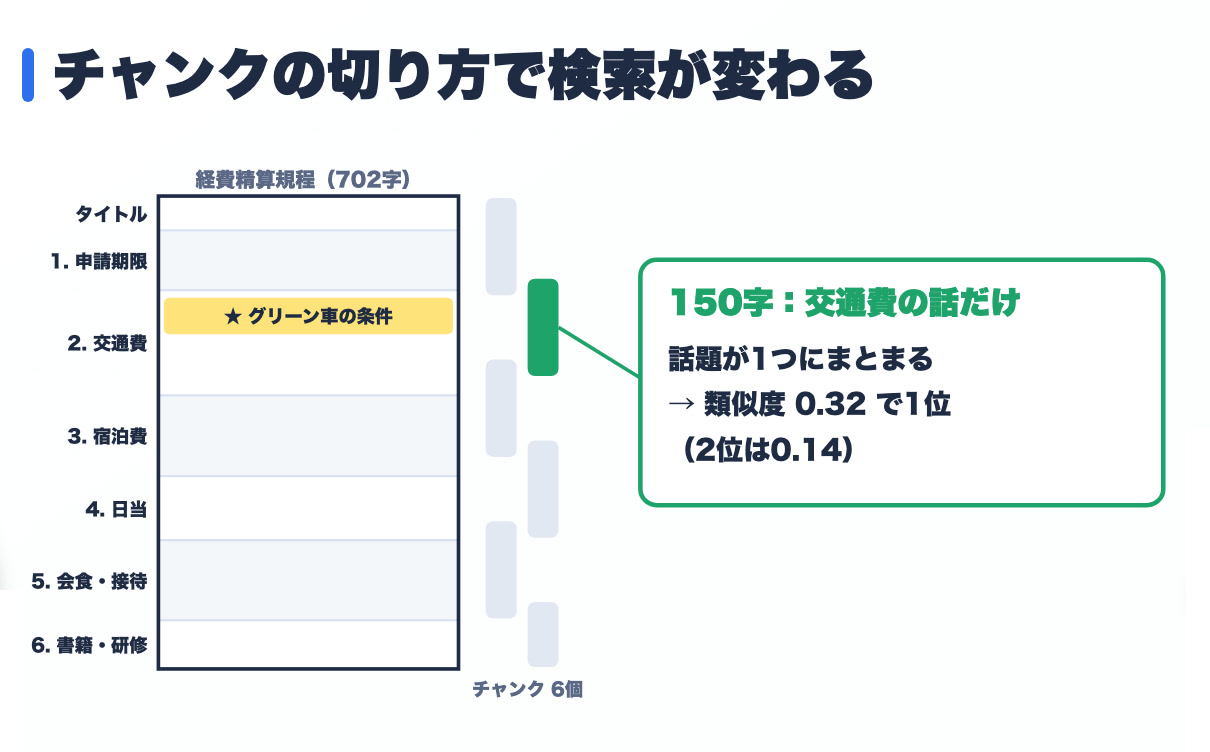
150 字にすると交通費の話だけのチャンクになり、類似度 0.32 で 1 位(2 位は 0.14)でした。
1000 字は資料まるごとで、全部で 6 個しかありません。3 件取ると全体の半分を渡すことになるので、当たりやすさの影響が大きいと考えています(Q20 は 2 位、類似度 0.04)。
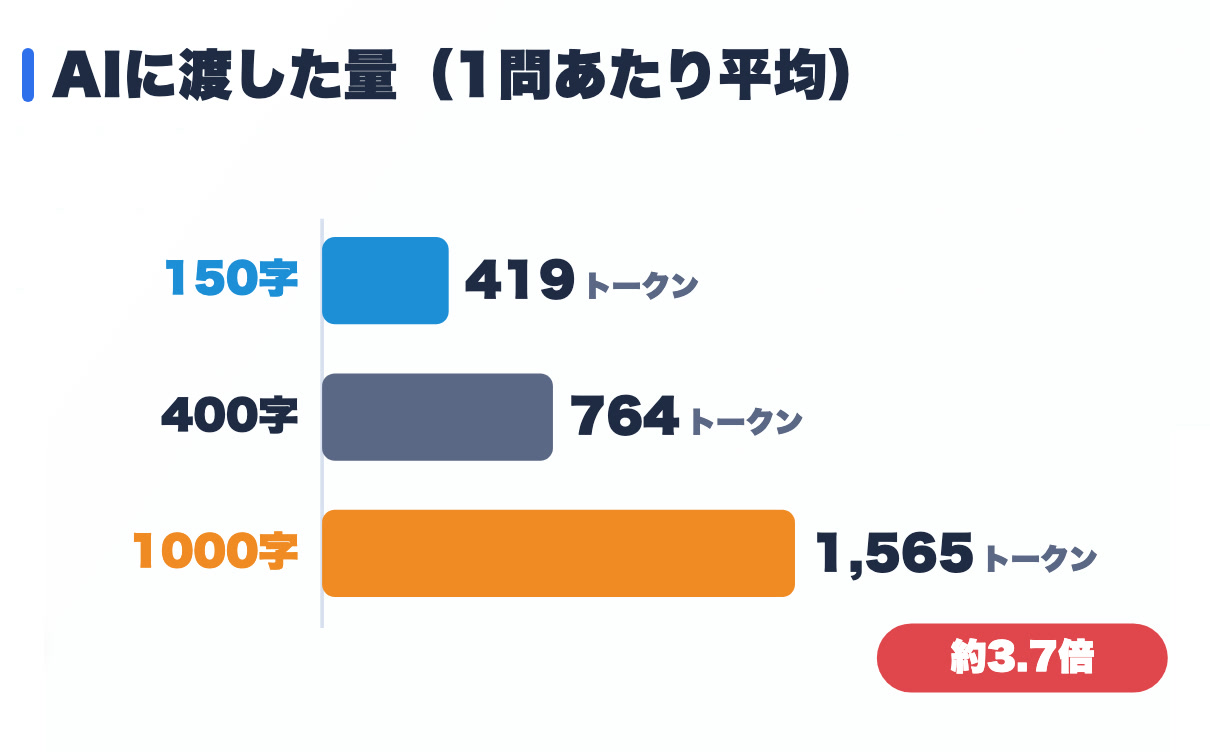
正解率が同じでも、1000 字は 150 字の約 3.7 倍のトークンを渡しています。料金も待ち時間も増えるので、今回の資料では 150 字がいちばん効率的でした。
8.2 取り出す件数
チャンクは 400 字に固定して、取り出す件数だけを変えました。
| 件数 | 正解率 | 入力トークン(平均) |
|---|---|---|
| 1 件 | 70% | 361 |
| 3 件 | 90% | 764 |
| 5 件 | 95% | 1,143 |
1 件だけだと、検索で 1 位を外したときに、答えの資料が AI に届きません。外した 6 問は、すべて根拠がコンテキストに入っていませんでした。
注意: 質問は 20 問しかないので、1 問で 5 ポイント動きます。数字は目安として見てください。
9. ハマったこと
- Claude のモデルが使えなかった。 最初は生成 AI に Claude Haiku を使う予定でした。しかし、このアカウントでは Anthropic モデルの「ユースケース申請」が未提出で、呼び出しが拒否されました。申請はアカウント側の手続きなので、申請の要らない Amazon Nova 2 Lite に切り替えました(
llm_model_id変数で戻せます)。 - 手元の PC から
jp.推論プロファイルを呼べなかった。 自分の IAM ユーザーに「東京以外のリージョンを Deny」するポリシーを付けていたためです。jp.プロファイルは東京と大阪に振り分けられるので、大阪に飛んだ瞬間に拒否されます。そこで、AI の呼び出しは EC2 の IAM ロール経由だけにしました。 - 4 並列で回すと遅くなった。 単発では 1 問 1 秒ほどですが、実験で 4 並列にすると、p50(中央値)が 3〜10 秒、最大 56 秒まで伸びました。Bedrock 側のスロットリング(呼び出し回数の制限で待たされること)と SDK のリトライによるものと推定しています(未確認)。
10. 費用
| 項目 | 目安 |
|---|---|
| EC2 t3.small(約 1 時間強。途中で 1 回作り直し) | 約 $0.03 |
| パブリック IPv4・EBS 20GB | 約 $0.01 |
| Nova 2 Lite(約 150 回、入力 約 10.8 万・出力 約 1.5 万トークン) | 約 $0.05〜0.1 |
| Titan Embeddings v2(約 5 万トークン) | $0.01 未満 |
| S3・SSM・EventBridge Scheduler・VPC | ほぼ $0 |
| 合計 | 約 $0.1〜0.15(20 円前後) |
使用量に単価を掛けた概算で、請求額ではありません。作業後は terraform destroy で全部消し、リソースが残っていないことも確かめました。
11. 次回への持ち越し
- チャンクを見出し単位で切り、「1 チャンク 1 話題」で 400 字の負けが解消するか確かめる
- Anthropic のユースケース申請を済ませて、Claude Haiku と Nova 2 Lite を同じ条件で比べる
- 正解判定にキーワード一致だけでなく、LLM による採点も併用する。拒否の判定は「記載はありません」のような表記ゆれに対応する
- 評価の質問を増やす(今は 1 問 = 5 ポイント)
- 言い換え(「在宅勤務」と「リモートワーク」)に強くするため、質問の書き換えやキーワード検索との併用を試す
おわりに
今回の資料では、150 字・3 件が正解率 100% で、AI に渡す量もいちばん少ない設定でした。1 件だけ取り出すと、検索で外した問題がそのまま誤答になりました。チャンクの大きさと件数は、正解率だけでなく料金と待ち時間にも直結します。
使った Terraform・RAG のコード・評価データのリポジトリは非公開です。