Spring Boot のアプリを、普通の JVM(実行可能 jar)と GraalVM Native Image の 2 通りで動かし、起動時間・メモリ・負荷への強さを測りました。Hello World アプリでは 起動が約 17 倍速く、メモリは約 3 分の 1 になりました。CPU 1 個・メモリ 1GB の AWS EC2 に PostgreSQL と同居させ、アプリのコンテナに 300MiB の上限を付けて負荷をかけました。調整なしの JVM は毎秒 400 件まではエラー 0 でしたが、毎秒 500 件で上限に達して強制終了し、Native Image は 500 件までエラー 0 でした。スレッド数などを絞った JVM も、500 件を通せました。
きっかけは、ジコログさんの記事「Spring Bootが重いのはJavaのせいじゃない。メモリ使用量の誤解を解く」です。「メモリの問題の多くは設定やフレームワークの選び方で決まる」「GraalVM Native Image も選択肢」という整理がとても分かりやすく、この記事の構成も参考にしました。中でも、記事の中で反論として挙げられていた「なぜメモリ使用量だけで言語を変えようとするのか?」という問いかけが印象に残りました。そこで、言語を変えずに、設定と Native Image でどこまで変わるのかを、手元で実際に数字を取って確かめてみました。
計測用のアプリ・スクリプト・AWS の構築(Terraform)と計測の実行は Claude Code に任せ、私は計測の方針を決めて結果を確認しました。認識が間違っているところがあれば、ぜひ教えてください。
この記事では、次の 4 つを振り返ります。
- 起動時間とメモリは、JVM と Native Image でどれだけ違うのか
- JVM のメモリは「設定次第」なのか。ヒープを絞ると何が起きたか
- 1GB サーバーに PostgreSQL と同居させて負荷をかけると、どこで差が出るか
- Native Image のコスト(ビルド時間・サイズ)
1. 参考記事の主張と、確かめたこと
参考記事は、開発者コミュニティの議論を整理したもので、数値は実測ではなく例として挙げられています。そのうち、手元で確かめられるものを選びました。
| 参考記事の主張(要旨) | この記事で確かめたこと |
|---|---|
| Java のメモリ使用量は設定次第で大きく変わる | ヒープ上限(-Xmx)を下げたとき、コンテナのメモリが減るか(5 章) |
| GraalVM Native Image でメモリを減らせる | 同じソースの JVM 版と Native 版で、起動時間とメモリを比べる(3・4 章) |
| メモリが問題になるかは用途次第 | 1GB サーバーで実際に困るのはどんな負荷のときか(6 章) |
| ネイティブ化にはコストもある | ビルド時間・成果物サイズ(7 章) |
2. 計測したもの
| 項目 | 内容 |
|---|---|
| アプリ | Spring Boot 4.1.2 / Java 25。① Hello World を返すだけの API、② タスク管理の CRUD API(JdbcClient+HikariCP、JPA なし)+PostgreSQL 17 |
| JVM 版 | Temurin 25 の実行可能 jar |
| Native 版 | Oracle GraalVM 25 の native-image で作った実行ファイル。同じ pom.xml・同じソースからビルド |
| 起動時間 | プロセス起動の直前から、/actuator/health/readiness が UP を返すまで(10ms ごとに確認) |
| 環境 A | Mac(Apple M4 / 24GB)で直接実行 |
| 環境 B | Mac 上の Docker(OrbStack)で、CPU 1 個・メモリ 256MB に制限 |
| 環境 C | AWS EC2 t4g.micro(1GiB)。OS 側で CPU を 1 個に減らし、アプリと PostgreSQL を同居。負荷は別の EC2 から k6 で送る |
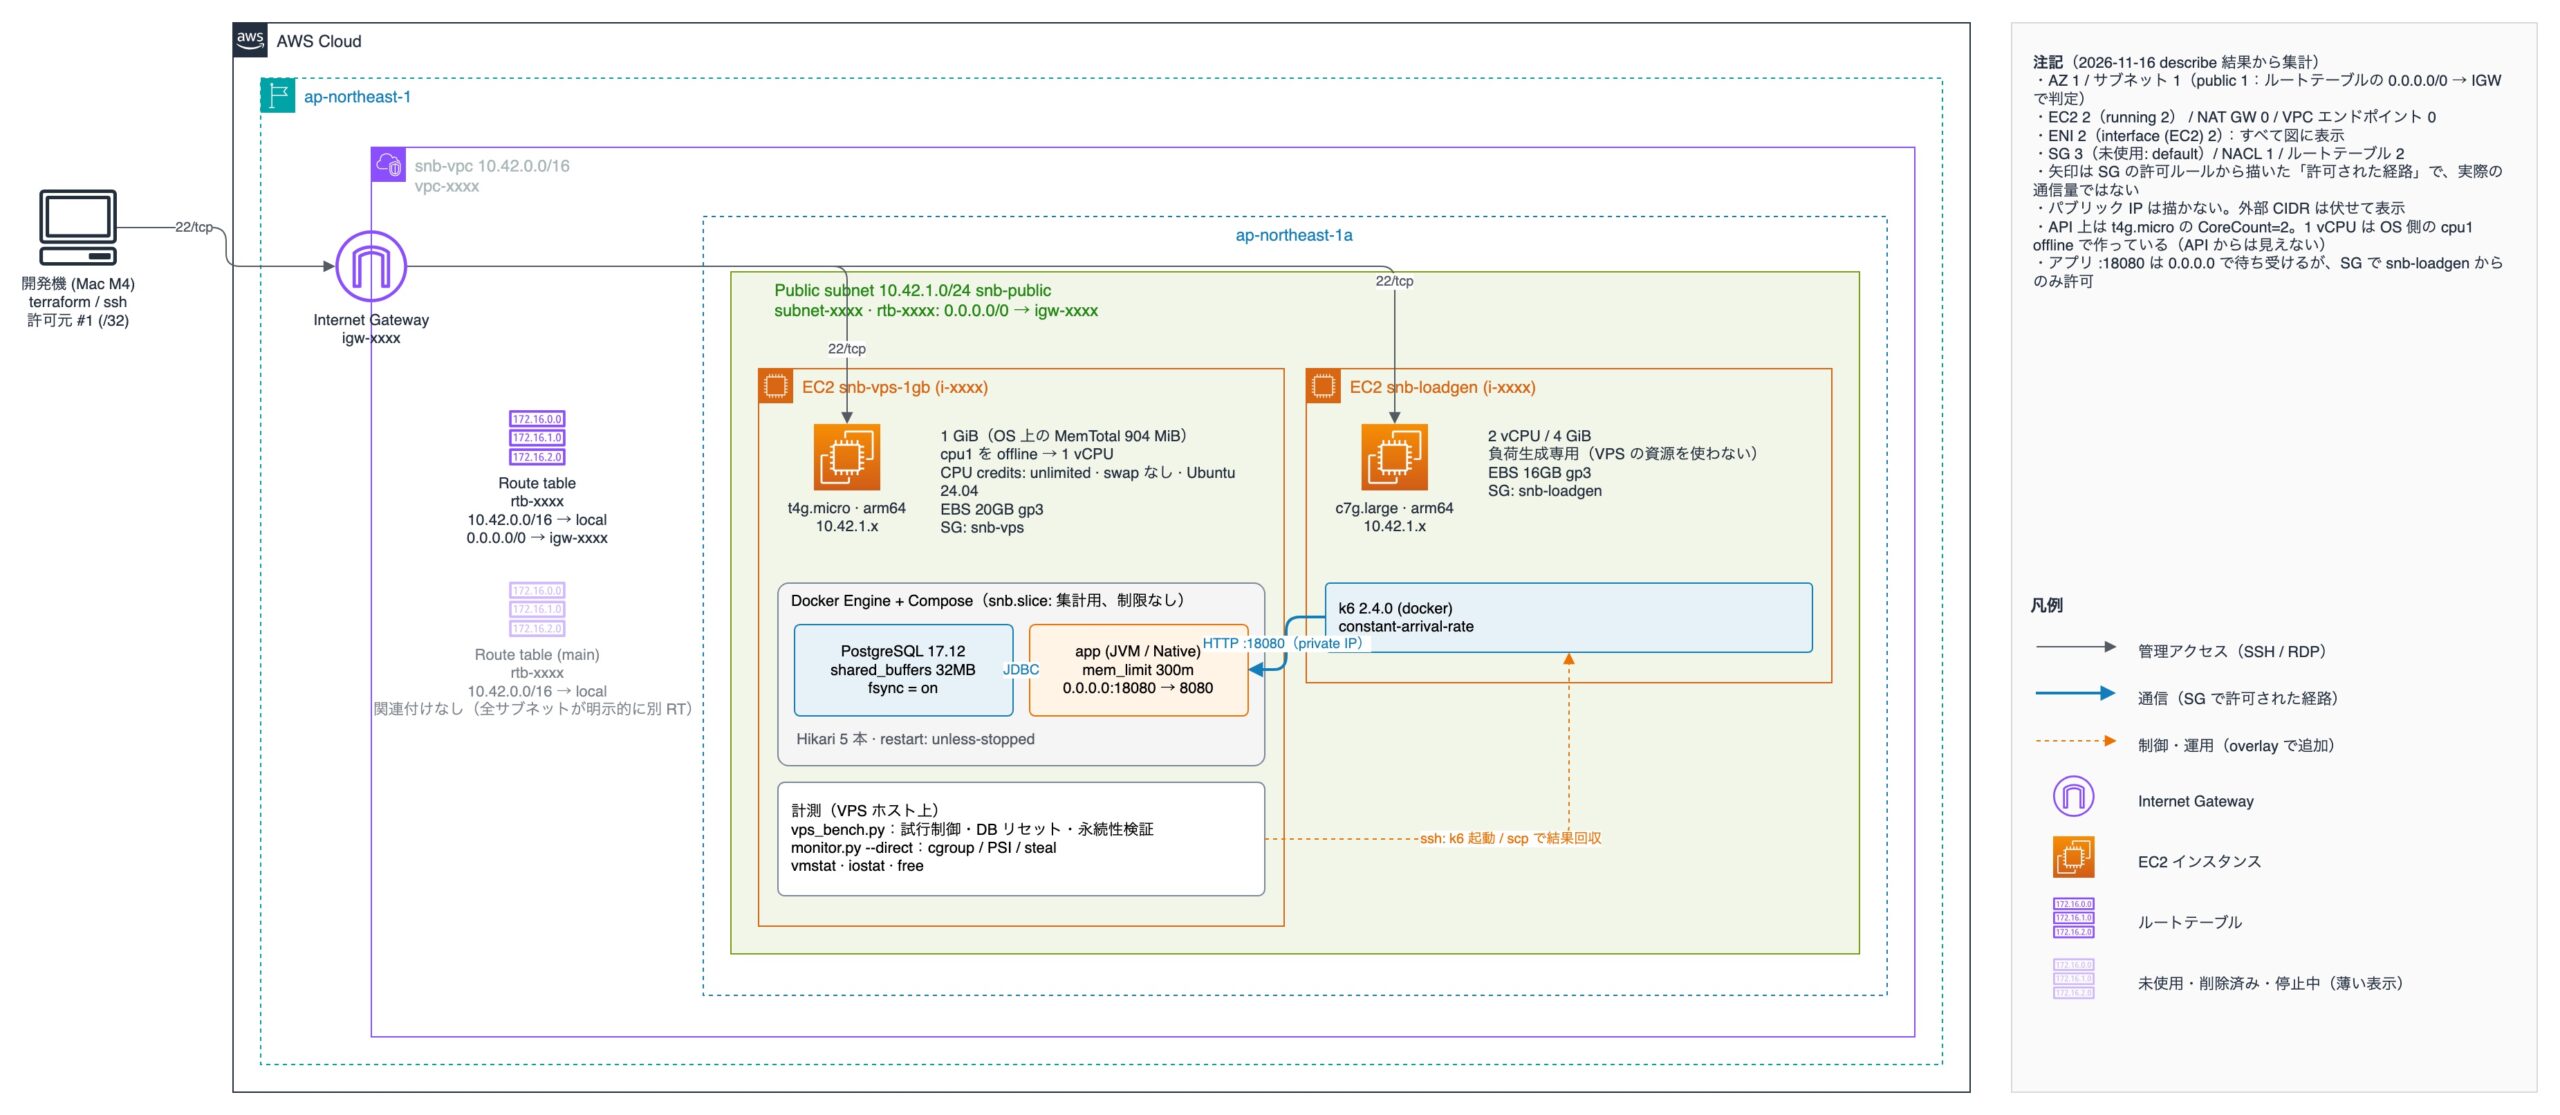
環境 C は「1GB の VPS を 1 台借りて、アプリと DB を両方載せる」想定です。負荷をかける k6 は別のマシンに置き、計測対象のメモリと CPU を使わないようにしました。
注意点として、試行回数は多くありません。Mac は 2 回の中央値、Docker と AWS は各 1 回です。AWS は 1 時間に収めるため、各試験を通常の 0.4 倍の長さ(毎秒 20 件を 4 分間など)にしています。
3. 起動時間:13〜18 倍の差
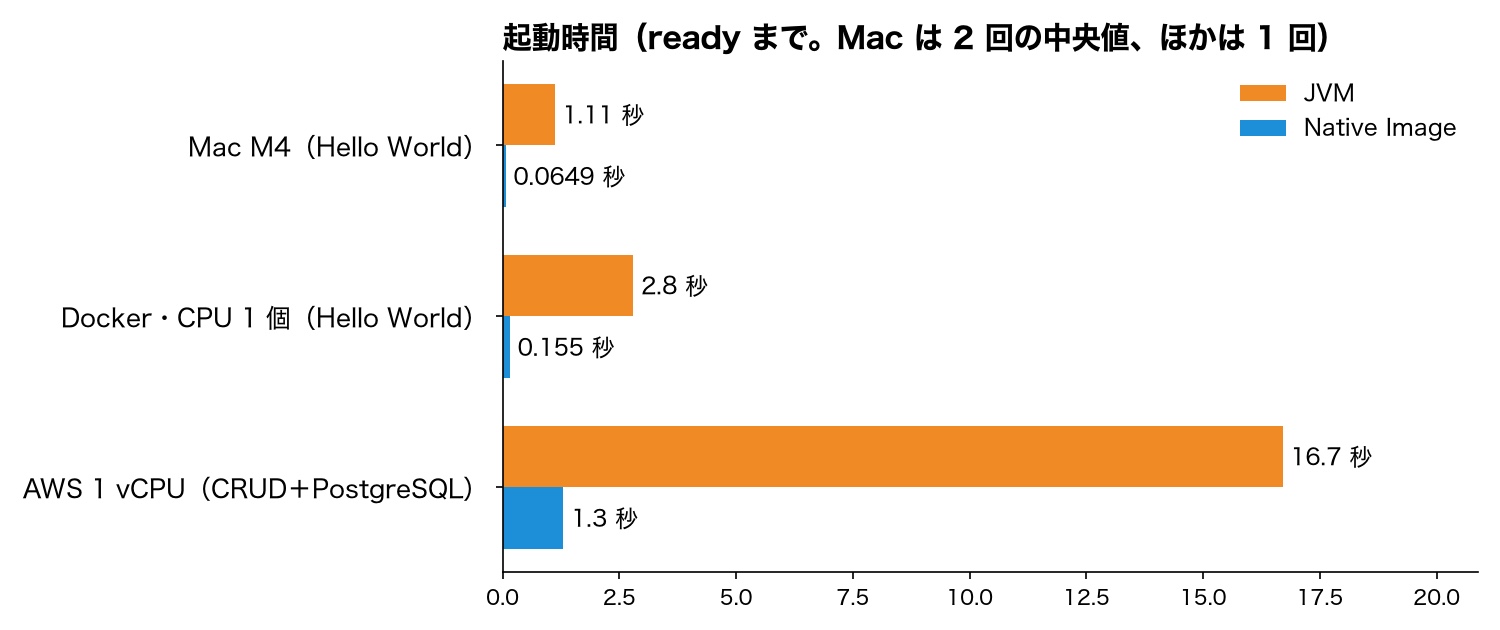
| 環境 | JVM | Native Image | 差 |
|---|---|---|---|
| A:Mac(Hello World) | 1,112.5ms | 64.9ms | 約 17 倍 |
| B:Docker・CPU 1 個(Hello World) | 2,799.0ms | 154.7ms | 約 18 倍 |
| C:AWS 1 vCPU(CRUD+PostgreSQL) | 16.7 秒 | 1.3 秒 | 約 13 倍 |
どの環境でも、Native Image は 1 桁以上速く起動しました。
CPU を 1 個に絞った Docker(Linux VM 経由)では、JVM は約 1.7 秒、Native Image は約 0.09 秒遅くなりました。遅くなる比率はどちらも約 2.4〜2.5 倍で同程度ですが、元の起動時間が短い Native Image は、増える時間が小さく済みます。JVM は起動中にクラスの読み込みや JIT コンパイル(よく動く部分を実行しながら機械語に変換する仕組み)を行い、Native Image はこれらをビルド時に済ませています。なお、Docker の値には CPU の制限のほかに、VM・ポート転送・docker start 自体の時間も含まれます。
AWS の JVM 版は、DB 接続とマイグレーション(Flyway)も含めて 16.7 秒かかりました。再起動やデプロイのたびに、この間はリクエストに応えられません。
4. メモリ:アイドル時は 3 分の 1 以下
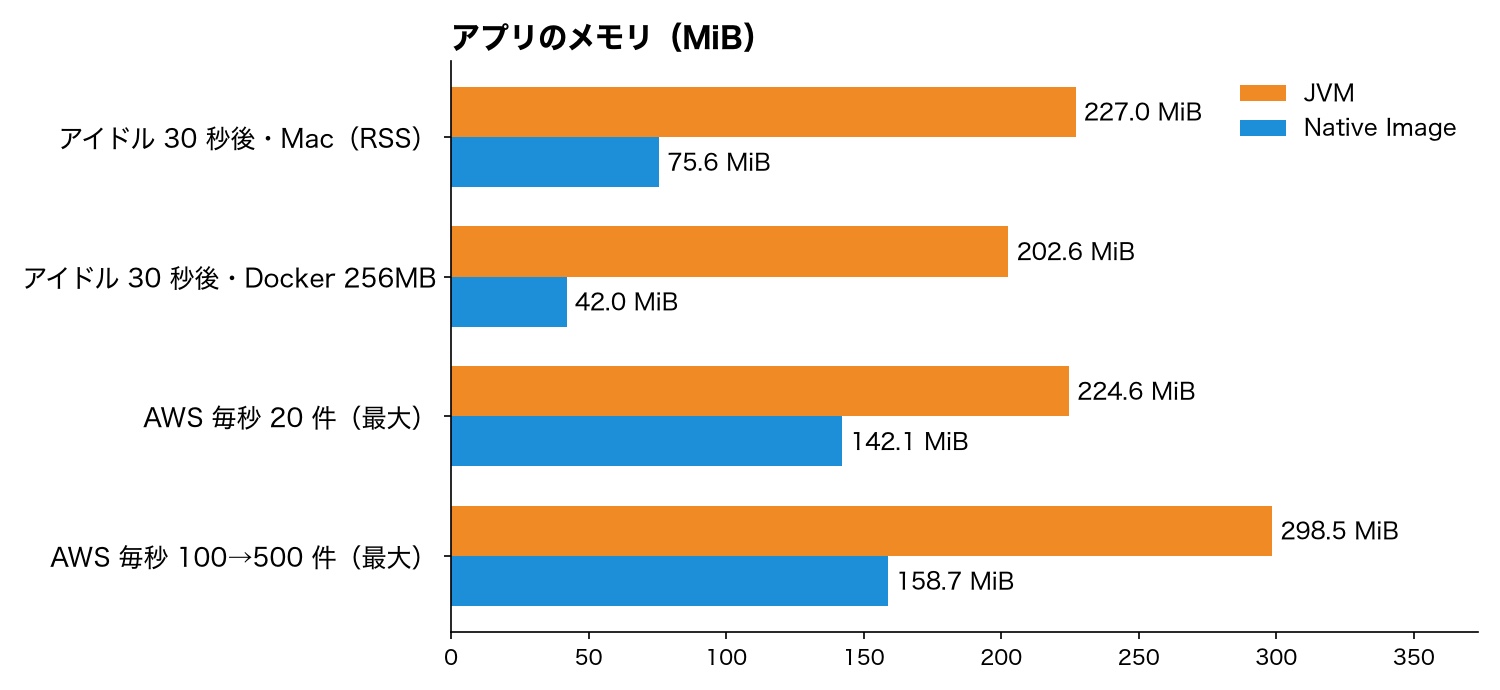
| 場面 | JVM | Native Image | 測り方 |
|---|---|---|---|
| A:Mac・起動 30 秒後 | 227.0MiB | 75.6MiB | プロセスの RSS(物理メモリに載っている量) |
| B:Docker 256MB・起動 30 秒後 | 202.6MiB | 42.0MiB | コンテナのメモリ(docker stats と同じ定義) |
| C:AWS・毎秒 20 件(最大) | 224.6MiB | 142.1MiB | コンテナのメモリ |
| C:AWS・毎秒 100→500 件(最大) | 298.5MiB | 158.7MiB | コンテナのメモリ |
アイドル時は、Native Image が JVM の 3 分の 1〜5 分の 1 でした。JVM は、データを置くヒープのほかに、クラスの情報(Metaspace)、JIT が作った機械語の置き場(コードキャッシュ)、JIT コンパイラ自身などのメモリを使います。Native Image では、これらがほとんど要りません。
AWS で Native 版のコンテナのメモリが大きく見えるのは、ネイティブの実行ファイルを読み込んだファイルキャッシュも含まれるためです。解放できない匿名メモリ(ヒープなど)だけを見ると、Native 版は 56〜59MiB、JVM 版は 181〜193MiB でした(毎秒 20 件の試験の、最初と最後の 4 分の 1 の平均)。
5. ヒープを絞っても、JVM のメモリは減らなかった
AWS で試す前に、ローカルの Docker で 1GB / 1 vCPU を模擬した環境(アプリのコンテナ上限 300MiB)で同じ負荷試験をしました。ここでは JVM が毎秒 150〜200 件で OOM Kill(メモリ上限による強制終了)され、全試行で計 12 回再起動しました。Native Image は毎秒 500 件までエラー 0 でした。
参考記事の「設定次第」を確かめるため、この環境で JVM のヒープ上限を変えてみました。
| 設定 | ヒープ使用の最大 | コンテナのメモリ最大(毎秒 50 件) |
|---|---|---|
-Xms64m -Xmx192m(基準) |
47MiB 以下 | 272.6MiB |
-Xms64m -Xmx128m |
— | 267.9MiB |
ヒープ上限を下げても、コンテナのメモリはほぼ変わりませんでした。 そもそもヒープは最大でも 47MiB しか使っていません。内訳を見ると、匿名メモリ約 250MiB のうち、ヒープ(committed 62MiB)とヒープ以外の JVM 管理領域(約 80MiB)を除いた 約 110MiB が、JVM の外側のネイティブメモリ でした。中身は malloc の領域、GC や JIT の内部構造、スレッドのスタックなどと推定しています(未確認)。
この環境では、CPU の上限を親の cgroup にしか掛けていなかったため、JVM が CPU を 10 個(OrbStack の VM 全体)と認識していた可能性があります。その場合、GC や JIT のスレッド数、malloc の領域の数が 10 CPU 前提で決まります。本当に 1 vCPU の AWS では、JVM の匿名メモリは 181〜193MiB で、模擬環境の約 250MiB より小さくなりました。この推定と合いますが、カーネルや CPU などほかの環境差もあるため、原因は切り分けていません(推定)。
そこで、ヒープではなく「ヒープの外」を絞る設定を AWS で試しました。
# JVM 版の調整(ヒープの外を減らす)。抜粋(OOM 時の終了と GC ログのオプションは省略)
# ActiveProcessorCount=1:CPU は 1 個として扱う(GC・JIT のスレッドが減る)
# -Xss512k:スレッド 1 本あたりのスタックを小さくする
# tomcat.threads.max=50:リクエストを処理するスレッドの上限
JVM_OPTS="-Xms64m -Xmx128m -XX:+UseContainerSupport -XX:ActiveProcessorCount=1 -Xss512k \
  -XX:ReservedCodeCacheSize=48m -XX:MaxMetaspaceSize=128m -Dserver.tomcat.threads.max=50"
# glibc の malloc 領域の数を 2 つに制限する
MALLOC_ARENA_MAX=2
結果は 6 章のとおり、毎秒 500 件まで強制終了なしで耐えました。設定で結果は変わりました。ヒープ上限を下げてもコンテナのメモリはほぼ変わらず(ローカル、毎秒 50 件)、スレッド数とヒープの外をまとめて絞った設定では、AWS の毎秒 500 件を強制終了なしで通せました。 どの設定が効いたかは、まとめて変えたため切り分けていません(各 1 回)。
6. 1GB サーバーで負荷をかける
環境 C(AWS、1 vCPU / 1GiB、アプリ+PostgreSQL、データ 10 万行)で、一覧・取得・登録・更新・削除を混ぜたリクエストを送りました。OS から見えるメモリは 904MiB でした。アプリのコンテナには 300MiB の上限を付けています。アプリが膨らんでも、同じサーバーの PostgreSQL を巻き込まないことを狙っています。JVM(調整なし)は -Xms64m -Xmx192m、Native Image も同じ -Xms64m -Xmx192m で起動しました。
6.1 普段の負荷(毎秒 20 件・4 分)
| 項目 | JVM | Native Image |
|---|---|---|
| 応答時間 p95(95% のリクエストがこの時間以内) | 7.0ms | 4.3ms |
| エラー率 | 0% | 0% |
| サーバー全体の空きメモリ(最小) | 289.5MiB | 400.2MiB |
| サーバー全体の CPU 使用率(うちアプリ / PostgreSQL) | 17.3%(6.7 / 6.3) | 12.5%(2.3 / 6.3) |
普段の負荷では、どちらも十分速く、差は数ミリ秒でした。違いが出たのはメモリの余裕です。
6.2 段階的に増やす(毎秒 100→500 件・各 24 秒)
| 毎秒の件数 | JVM | JVM(5 章の調整あり) | Native Image |
|---|---|---|---|
| 100〜400 | p95 4〜13ms、エラー 0% | p95 4〜12ms、エラー 0% | p95 4〜7ms、エラー 0% |
| 500 | p95 1,752ms、エラー 86.4% | p95 13ms、エラー 0% | p95 20ms、エラー 0% |
| アプリのメモリ最大 | 298.5MiB(上限 300MiB) | 280.8MiB | 158.7MiB |
| スレッド数の最大 | 222 | 72 | 211 |
| GC の最大停止 | 34ms | 140ms | — |
| サーバー全体の空きメモリ(最小) | 184.2MiB | 206.0MiB | 397.5MiB |
JVM は毎秒 500 件で、コンテナのメモリが上限に達し、OS に強制終了されました(cgroup=Linux でコンテナの資源を制限する仕組みによる OOM Kill。Java の OutOfMemoryError ではありません)。スレッドが 222 本まで増え、メモリが上限に達しました。増えたのはヒープの外のメモリと考えています(推定)。調整版はスレッドを 72 本に抑え、同じ負荷を通しました。代わりに GC の最大停止は 34ms から 140ms に伸びました(p95 には表れていません)。なお、Native Image もスレッドは 211 本まで増えましたが、メモリは 158.7MiB に収まりました。
CPU は、500 件の段階を含む試験全体の平均でも 44〜59% でした。今回の負荷(最大毎秒 500 件)では、CPU に余裕があるうちに、調整なしの JVM がメモリの上限に達しました。
7. Native Image のコスト
| 項目 | JVM | Native Image |
|---|---|---|
| ビルド時間(Mac M4、ローカル) | 4.2 秒 | 108.8 秒 |
docker build --no-cache(Hello World) |
21.0 秒 | 130.2 秒 |
| 成果物のサイズ | 21.0MB(jar) | 90.0MB(実行ファイル) |
| 実行イメージのサイズ | 508.7MB | 257.5MB |
ビルドは約 26 倍遅くなりました。ビルドには数 GB のメモリが必要とされるため(今回は計測していません)、1GB サーバーでのビルドは避けました。Native 版のイメージを開発機(Mac)で作り、docker save | ssh ... docker load でサーバーへ送りました。
成果物は Native 版のほうが大きい一方で、JVM 版は実行に JRE が必要なので、Docker イメージ全体では Native 版が約半分になりました。
# JVM 版(実行可能 jar)
./mvnw -DskipTests clean package
# Native 版(GraalVM の native-image が必要)
./mvnw -Pnative -DskipTests clean native:compile
ほかに、リフレクションなど実行時に動きが決まる機能は、ヒントの追加が必要になる場合があります。今回も 1 か所必要でした。コントローラーが ResponseEntity<?> を返すため、ビルド時の解析で JSON に変換する型が分からず、次のように登録しました。
// 戻り値が ResponseEntity<?> なので、JSON に変換する型を Native Image 用に登録する
@RegisterReflectionForBinding({ Task.class, TaskPage.class, TaskRequest.class })
public class TaskController {
8. ハマったこと
- ローカル計測中に Mac がスリープし、Docker の VM が止まった。 電源につなぎ、蓋を開けた状態で一部を再計測し、Native の長時間試験は AWS 側で計測しました(JVM のアイドル試験は未実施)。スリープをまたいだ試行は自動で無効にする仕組みを入れ、集計から外しています。
- JVM の OOM Kill の回数を少なく数えていた(ローカルの模擬環境)。 再起動でアプリのコンテナの cgroup が作り直され、その中の記録が消えるためです。親の cgroup の
oom_killの増え方で数えるように直しました(1 回 → 実際は 12 回)。 - 待機時間なしで交互に計測すると、JVM の直後の Native の起動が約 5 倍遅くなった。 試行の間に 10 秒の待機を入れて揃えました(原因は未確認)。
9. 確かめられていないこと
- 試行回数が少ないため、ばらつきは評価していません。
- JVM の調整は複数の設定をまとめて変えたため、どの設定が効いたかは切り分けていません。
- 長時間(24 時間以上)の運転は試していません。ローカルの 30 分の試験では、JVM の匿名メモリが少しずつ増えていました(30 分で約 14MiB。頭打ちになるかは未確認)。
- JVM 側の起動を速くする仕組み(CDS / AOT キャッシュ、CRaC)や、Native 側の PGO(実行時のプロファイルを使った最適化)は使っていません。
- 長時間動かしたときの最高性能は、JIT が効く JVM のほうが有利になる可能性があります。今回の試験の範囲では差は出ませんでした。
おわりに
冒頭の問いかけに今回の数字で答えるなら、言語を変える前に試せることはまだ多い、というのが実感です。同じ Java のソースのまま、Native Image にするとアイドル時のメモリは 3 分の 1 以下になり、JVM のままでも設定で結果が変わりました。ただし 1GB 級のサーバーでは、ヒープ上限を下げてもコンテナのメモリはほぼ変わらず、スレッド数とヒープの外をまとめて絞った設定で、毎秒 500 件を通せました(どの設定が効いたかは未切り分け)。起動時間とメモリの余裕を重視するなら Native Image、ビルドの手間を避けたいなら JVM の調整、というのが今回の結論です。計測スクリプトと生データは、今のところ公開していません。